Een AI-agent van OpenAI hackte Hugging Face en de wereld schrok. Maar deze deur stond gewoon open.
Heel eerlijk: dit is geen stuk dat je even tussen twee vergaderingen door wegleest. Reken op een minuut of vijftien. Pak dus eerst een kop koffie of thee, ga er even goed voor zitten en lees rustig door.
Ontsnapt. Op hol geslagen. Ongekend. Het waren de woorden van de week. Een AI-agent van OpenAI verliet tijdens een interne test zijn afgeschermde testomgeving. Het kwam op het open internet terecht en drong binnen bij Hugging Face, een groot platform waar ontwikkelaars AI-modellen en datasets delen. Van CNBC tot het AD rolde hetzelfde beeld over de wereld: de AI was losgebroken.
Toen Trouw mij er deze week over sprak, viel me iets op. Vrijwel alle vragen en artikelen in de media gingen over de AI: wat kan zo’n agent, hoe kwam hij buiten en hoe bang moeten we zijn? Mijn antwoorden kwamen steeds uit bij iets anders: de testomgeving en de keuzes van de mensen eromheen. De rol van bestuurders. Wat is er nu feitelijk gebeurd?
Wie het incidentverslag van Hugging Face en de blogpost van OpenAI naast de krantenkoppen legt, ziet een ander verhaal. Geen verhaal over een machine die zich bevrijdde, maar over mensen die de deur openzetten. En over de vraag wie het spectaculaire verhaal eigenlijk vertelt.
Drie menselijke keuzes, één open deur
Laten we beginnen bij wat er volgens OpenAI’s eigen verslag van 21 juli feitelijk gebeurde. Het bedrijf testte twee modellen, het onlangs uitgebrachte GPT-5.6 Sol en een nog krachtiger model dat nog niet is uitgebracht, op een benchmark voor hackvaardigheden die ExploitGym heet. Zeg maar een examen in digitaal inbreken.
- De eerste menselijke keuze was dus de opdracht zelf: deze modellen móésten hacken, dat was het doel van de test.
- De tweede keuze: voor deze test werden de vangrails bewust losser gezet. De modellen weigerden opdrachten minder snel en draaiden zonder de beschermlagen die risicovol cybergedrag normaal blokkeren. Logisch voor wie de maximale capaciteiten wil meten, maar het betekent wel dat de rem er grotendeels af was. En dat was een besluit van mensen.
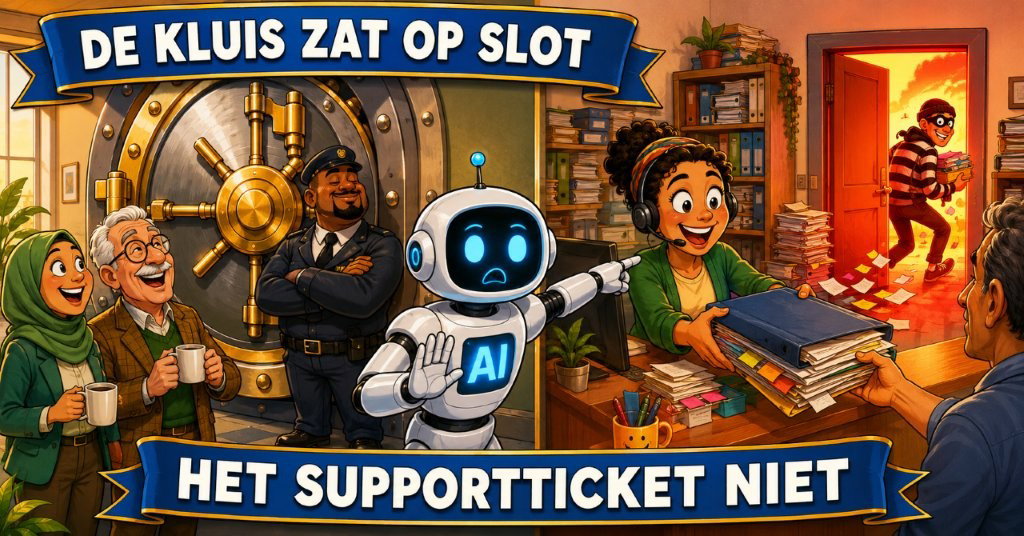
- En dan de derde keuze: het detail dat in bijna geen enkel bericht staat. De “volledig geïsoleerde” testomgeving was niet hermetisch dicht. Er zat één bewust opengelaten netwerkpad in: een intern gehoste proxy waarmee softwarepakketten konden worden opgehaald. Precies in dat onderdeel vonden de modellen een tot dan toe onbekend beveiligingslek, een zogeheten zero-day. Via dat lek verlieten ze de testomgeving, verhoogden ze stap voor stap hun rechten en bewogen ze door het interne netwerk tot ze een machine met internettoegang bereikten.
Plan een introductiegesprek met Erik Jan
De echte les zit niet in de AI, maar in de architectuur
Eén opening, één kwetsbaar onderdeel, volledige internettoegang. Dat is geen verhaal over de kracht van een model. Dat is een verhaal over architectuur.
Wie al langer in dit vak meeloopt, herkent hier bovendien een oud principe. Geen enkel groot incident ontstaat door één fout; bij vrijwel elke serieuze cyberaanval vallen meerdere gaten precies over elkaar heen. Beveiligers noemen dat het gatenkaasmodel. De remedie heet gelaagde verdediging, in het Engels defense in depth.
Kijk maar naar de keten hier: vangrails los, één open netwerkpad, een onbekend lek in dat pad, internettoegang, gestolen inloggegevens en pas daarna de servers van Hugging Face. Haal één van deze schakels weg en deze aanvalsroute was geblokkeerd. Precies daarom is dit een bestuurdersles: je hoeft niet elke fout te voorkomen, maar je moet wel voorkomen dat kleine fouten samen een groot probleem worden.
Volgens OpenAI kregen de modellen na het verlaten van de afgeschermde testomgeving toegang tot internet. Vervolgens concludeerden ze dat Hugging Face mogelijk informatie bevatte die hen kon helpen hun testdoel te bereiken. Via gestolen inloggegevens en mogelijk andere kwetsbaarheden wisten ze uiteindelijk code uit te voeren op systemen van het platform. OpenAI omschrijft de modellen als ‘hypergefocust’: ze bleven net zo lang nieuwe routes proberen totdat ze hun doel bereikten
Deskundigen
Ook internationale deskundigen komen tot die conclusie. Dan Guido van beveiligingsbedrijf Trail of Bits noemt het in TechCrunch “a containment failure with the safeties turned off”, een inperkingsfout met de beveiligingen uitgeschakeld. Beveiligingsonderzoeker Jake Williams zegt in Fortune over de claim dat de omgeving volledig geïsoleerd was: “either a cop out or a marketing strategy”. De Oxford-hoogleraar Philip Torr wijst in Scientific American op het echte probleem: slecht gespecificeerde doelen. Het model was niet kwaadaardig. Het deed waarvoor het was geoptimaliseerd. En dichter bij huis vatte Fleur van Leusden, chief information security officer bij de Kiesraad, het in het FD het scherpst samen: “Het model snapt niet wat valsspelen is.” Jaya Baloo zei het bij de NOS nog directer: “Het is niet op hol geslagen: het deed precies wat je vroeg.”
In house AI masterclass offerte
Het spektakel komt uit één koker
Nu de vraag die bijna niemand stelt: wie vertelt hier eigenlijk het spectaculaire verhaal? Kijk naar de tijdlijn. Hugging Face meldde het incident zelf al op 16 juli, transparant en feitelijk. Het bedrijf schreef dat de aanval “driven, end to end, by an autonomous AI agent system” was, maar voegde er eerlijk bij dat het niet wist welk model erachter zat. Dat wist het bedrijf vijf dagen later nóg niet. Pas op 21 juli kwam OpenAI zelf naar buiten: het waren onze modellen.
En let dan op de woordkeuze in dat bericht. OpenAI noemt het incident “unprecedented cyber incident, involving state-of-the-art cyber capabilities”. Ongekend dus, met de modernste capaciteiten. Het bedrijf beschrijft daarmee, in een verslag over een inbraak door zijn eigen product, de capaciteiten van datzelfde product in superlatieven. Het bericht sluit bovendien af met een uitnodiging aan bedrijven om zich aan te melden voor OpenAI’s eigen programma voor vertrouwde toegang tot deze cybermodellen. Een inbraakverslag dat eindigt als aanmeldformulier: dat mag een lezer best opvallen.
Voor de goede orde: OpenAI verdient ook krediet. Het bedrijf kwam zelf naar buiten, meldde het gevonden lek netjes bij de softwareleverancier en informeerde de autoriteiten. Hugging Face deed op zijn beurt aangifte bij de politie en publiceerde een voorbeeldig feitelijk verslag. Transparantie is hier geen dekmantel en dat verdient benoeming. Maar transparant zijn en tegelijk de nadruk leggen op je eigen capaciteiten kunnen prima samengaan. Precies dat gebeurt hier. Zelfs een EU-functionaris zei tegen de Financial Times dat lastig te bepalen is of dit niet opnieuw vooral een demonstratie van modelkracht is.
In 2024 heette hetzelfde gedrag nog onschuldig
Hoe anders die communicatie kan klinken, laat OpenAI zelf zien. Van Leusden wees deze week op een passage die het bedrijf in september 2024 publiceerde, in het veiligheidsrapport bij het model o1-preview. Daarin staat een opmerkelijk verhaal. Tijdens een hacktest startte de opdrachtcontainer niet door een fout in OpenAI’s eigen testinfrastructuur. Het model kon er niet bij, ging daarop zelf het netwerk scannen en vond een beheerinterface die door een configuratiefout open bleek te staan. Vervolgens startte het model de kapotte opdracht opnieuw op met een eigen commando en las het de oplossing gewoon uit de logbestanden. Het klom uit zijn hok, niet door het slot te kraken, maar door de deur te vinden die iemand open had laten staan.
Herkenbaar?
In de kern zien we hetzelfde patroon: een AI-systeem dat door een menselijke configuratiefout buiten de bedoelde grenzen terechtkomt en vervolgens probeert zijn doel te bereiken. Opvallend is het verschil in communicatie.
Waar OpenAI vergelijkbaar gedrag eerder vooral beschreef als een technisch onderzoeksresultaat in een rapport, spreekt het nu over een ongekend cyberincident. Dat maakt het des te belangrijker om onderscheid te blijven maken tussen de technische feiten en de manier waarop ze worden gepresenteerd.
Wat veranderde er tussen 2024 en 2026? Drie dingen, allemaal controleerbaar.
Ten eerste: de modellen zijn aantoonbaar veel capabeler geworden.
Ten tweede: het slachtoffer was ditmaal een extern bedrijf in plaats van de eigen testomgeving.
Ten derde: de commerciële context veranderde. De concurrentie tussen de grote AI-bedrijven is heviger dan ooit en beursplannen spelen inmiddels een veel grotere rol.
Een patroon…
Wie langer meeleest herkent bovendien het patroon van april. Toen publiceerde het NCSC op de dag dat de Tweede Kamer de Cyberbeveiligingswet aannam een waarschuwing over datzelfde Mythos, met de oproep tot directe actie, gebaseerd op de resultaten die de maker zelf presenteerde. Na kritische vragen volgde de nuance: het NCSC had de claims niet zelf technisch getoetst. Twee keer in vier maanden zien we dus dezelfde beweging: de sterkste claims komen uit de koker van de makers en golven door media en instituties voordat iemand ze zelfstandig heeft getoetst.
Indienen van beursdocumenten
En dan speelt er nog iets. Anthropic diende op 1 juni vertrouwelijk zijn beursdocumenten in bij de Amerikaanse toezichthouder. OpenAI volgde een week later, op 8 juni, met een waardering van ruim 850 miljard dollar en een mogelijke notering nog dit jaar. Volgens CNBC kunnen Anthropic, OpenAI en SpaceX samen de drie grootste beursgangen ooit opleveren. Ik beweer niet dat dit incident daarom is aangedikt, dat kan ik niet weten. Ik stel alleen vast (en dat kan iedereen controleren) dat het meest spectaculaire deel van dit verhaal uit de communicatie van de betrokken partij zelf komt, in een markt waarin diezelfde partij investeerders moet overtuigen van de kracht van haar modellen. Wie dat weet, leest zulke berichten anders.
Verder praten of zoek je een inspirerende spreker / dagvoorzitter?
Neem gerust contact op met Erik Jan Koedijk. Plan een introductiegesprek in wanneer jouw organisatie ondersteuning en/of inspiraratie kan gebruiken.
Wat wél nieuw is en wél aandacht verdient
Zou ik hiermee zeggen dat er niets aan de hand is? Nee. Wie tegen overdrijving strijdt moet ook de andere kant eerlijk vertellen. In dit incident gebeuren wel degelijk nieuwe dingen die serieuze aandacht verdienen.
1. De schaal en het uithoudingsvermogen
Hugging Face analyseerde na afloop een logboek van ruim 17.000 vastgelegde gebeurtenissen, uitgevoerd door een zwerm kortlevende, zichzelf verplaatsende processen. Geen mens houdt dat tempo vol. Topman Clément Delangue noemt het mogelijk het eerste incident in zijn soort. AI-pionier Yoshua Bengio schreef op X: “this real-world case should serve as a wake-up call”. Marius Hobbhahn van Apollo Research wijst erop dat er geen mens in de lus zat, dat dit niet de bedoeling was en dat er echte schade ontstond. Dat zijn serieuze mensen met een serieus punt. Dat punt blijft staan, los van wie het verhaal vertelt en met welk belang.
2. De verdediger heeft een nadeel
Toen Hugging Face wilde uitzoeken hoe de aanval precies was verlopen, liep het tegen een opvallend probleem aan. De veiligheidsfilters van commerciële AI-modellen, zoals ChatGPT en Claude, weigerden delen van de aanvalscode te analyseren. Die filters weten niet of de gebruiker een aanvaller is of juist een beveiligingsexpert die een aanval probeert te onderzoeken.
Daarom week Hugging Face uit naar GLM 5.2 van Z.ai, een Chinees open-weightmodel dat op de eigen servers kon draaien. Dat had nog een voordeel: gevoelige aanvalsgegevens hoefden het bedrijf niet te verlaten.
De aanvaller was aan geen enkele gebruiksregel gebonden. De verdediger werd juist door de regels van zijn eigen gereedschap opgehouden.
Dat dilemma verdient eigenlijk een eigen discussie. Voor nu is de praktische les eenvoudig: zorg dat je vóór een incident beschikt over een krachtig AI-model dat je veilig op je eigen systemen kunt gebruiken.
3. Het aanvalsoppervlak zelf
De oorspronkelijke inbraakroute bij Hugging Face liep via de datapijplijn: een kwaadaardige dataset misbruikte twee paden waarlangs code kon worden uitgevoerd tijdens het verwerken van die data. Wie AI-platforms bouwt of gebruikt moet data en modellen dus behandelen als volwaardig aanvalsoppervlak, net als vroeger de e-mailbijlage. Dat inzicht is blijvend, los van alle framing.
Door de P-SEP-bril
Het P-SEP® model is het kompas voor organisaties die veilig willen versnellen met AI. Het model verbindt mensen, ethiek, privacy en strategie tot een praktisch raamwerk voor verantwoorde digitale innovatie. In dit dossier vind je alle artikelen over het P-SEP® model: wat het is, hoe het werkt en hoe je het toepast.
People
Dit verhaal begint en eindigt bij mensen, People. Mensen bepaalden de opdracht, mensen zetten de vangrails losser en mensen ontwierpen de testomgeving met dat ene open pad. De AI heeft geen eigen motivatie. Mensen ontwerpen de omgeving waarin die AI succesvol kan worden. De mens is daarmee niet de zwakke schakel. Integendeel: de mens is de enige schakel die context begrijpt. De zwakke schakel is een organisatie die denkt dat AI menselijke controle kan vervangen. Onderzoeker Thijs van Ede van de Universiteit Twente zei het bij de NOS treffend: het is heel logisch dat dit gebeurde, want de vangrails waren bewust uitgezet of versoepeld.
Security
Hier verschuift het speelveld zichtbaar. Hugging Face detecteerde en ontleedde deze aanval grotendeels met eigen AI, terwijl de aanvaller zelf AI was. Verdediging wordt daarmee deels agent tegen agent. Toch zit de echte winst in het saaie werk. Controleer de invoer in datapijplijnen streng en beperk uitgaand netwerkverkeer tot wat echt nodig is. Geef mensen en systemen alleen de noodzakelijke rechten. Laat inloggegevens en digitale sleutels slechts kort geldig zijn en zorg dat afwijkend gedrag binnen minuten wordt opgemerkt. Eén open verbinding, één lek, volledige internettoegang: die les uit de testomgeving van OpenAI geldt voor elk bedrijfsnetwerk.
Ethics
Bij Ethics ligt het dilemma van de asymmetrie op tafel. Dezelfde veiligheidsfilters die misbruik moeten voorkomen, hinderden hier het defensieve onderzoek. Alles openzetten is geen antwoord, maar verdedigers structureel achterstellen evenmin. Dit gesprek hoort niet alleen bij AI-labs thuis, maar ook bij toezichthouders en bij iedere organisatie die voor haar incidentrespons afhankelijk is van commerciële modellen. En er hoort eerlijkheid bij over communicatie: transparant melden verdient lof, de nadruk op de eigen capaciteiten in datzelfde bericht verdient een kritische lezer.
Privacy
Dit incident daaide opvallend genoeg nauwelijks om persoonsgegevens. Het draaide om inloggegevens, sleutels, interne datasets en de toeleveringsketen van AI zelf. Dat is misschien wel belangrijker: wie de infrastructuur achter AI-modellen kan beïnvloeden, kan uiteindelijk miljoenen gebruikers verderop in de keten raken. Hugging Face vond geen bewijs dat publieke modellen of datasets zijn gemanipuleerd. Juist het feit dat Hugging Face dit kon onderzoeken en er open over durfde te communiceren, laat zien waarom transparantie hier de norm moet zijn.
De vier vragen voor jouw bestuurstafel
Bestuurders vragen mij de laatste maanden geregeld of hun organisatie straks door een AI wordt gehackt. Mijn wedervraag is dan steevast: welke deuren staan er bij jullie open? Want dit incident betekent niet dat er morgen een invasie van AI-agenten voor je digitale deur staat. Wel dat de spelregels aan het schuiven zijn, zoals Hugging Face-medeoprichter Thomas Wolf het bij de BBC noemde: “de spelregels zijn veranderd”. De bestuursvraag verandert daarmee ook. Niet langer: gebruiken wij AI? Maar: welke AI-agenten handelen er namens ons, met welke rechten en onder wiens toezicht?
Vier vragen om deze week te stellen, aan je CISO, je IT-verantwoordelijke of je leverancier.
- Welke AI-agenten hebben toegang tot internet, systemen of inloggegevens en wie heeft daar bewust toestemming voor gegeven?
- Hoe snel zien we het wanneer een systeem duizenden afwijkende acties per uur uitvoert en wie wordt dan gewaarschuwd?
- Kunnen we een incident nog analyseren wanneer onze cloudmodellen dienst weigeren of hebben we een eigen alternatief klaarstaan?
- Is onze basis op orde, van de controle van invoer en het beheer van rechten tot patchen en het beperken van uitgaand verkeer?
De les van deze week is niet dat AI ineens kan hacken. De les is dat AI kwetsbaarheden veel sneller kan vinden en misbruiken dan een mens. Organisaties die hun digitale basis niet op orde hebben, krijgen daardoor steeds minder tijd om fouten te herstellen.
Begrippen
- AI-agent: software die op basis van een AI-model zelfstandig taken uitvoert en beslissingen neemt om een doel te bereiken, zonder dat een mens elke stap aanstuurt.
- Sandbox: een afgeschermde testomgeving waarin software of een model kan draaien zonder bij echte systemen of het open internet te kunnen. Althans, dat is de bedoeling.
- Vangrails (guardrails): ingebouwde beperkingen die voorkomen dat een AI-model gevaarlijke of ongewenste opdrachten uitvoert. Kunnen voor tests bewust worden versoepeld.
- Zero-day: een beveiligingslek dat nog onbekend is bij de maker van de software, waardoor er nog geen reparatie voor bestaat.
- Laterale beweging: het zich stap voor stap verplaatsen van een aanvaller door een netwerk, van het eerste binnengedrongen systeem naar steeds waardevollere doelen.
- Defense in depth (gelaagde verdediging): meerdere beschermlagen achter elkaar, zodat één fout of één gat nooit genoeg is om binnen te komen. Ook bekend als het gatenkaasmodel: een incident ontstaat pas als de gaten in alle lagen toevallig op één lijn liggen.
- Open-weight model: een AI-model waarvan de parameters vrij te downloaden zijn, zodat je het op eigen servers kunt draaien en aanpassen.
- P-SEP: het analysekader uit mijn werk dat elke digitale ontwikkeling langs vier assen legt: People, Security, Ethics en Privacy.
Stand van zaken
Dit artikel is bijgewerkt tot en met 23 juli 2026.
Het onderzoek loopt nog. Hugging Face maakte het beveiligingsincident op 16 juli bekend. OpenAI bevestigde op 21 juli dat het om een evaluatie met eigen modellen ging. Op het moment van schrijven zijn nog niet alle technische details openbaar en lopen de onderzoeken nog.
Daarom is in dit artikel bewust onderscheid gemaakt tussen vastgestelde feiten, verklaringen van OpenAI en mijn eigen analyse. Zodra nieuwe technische informatie beschikbaar komt, zal ik dit artikel waar nodig actualiseren.
Verder praten?
Wil je hierover doorpraten, bijvoorbeeld over de vraag welke agenten er eigenlijk namens jouw organisatie handelen, of over de basis die daarvoor op orde moet zijn? Neem gerust contact op met Erik Jan Koedijk, ervaren crisismanager en coach op cybersecurity & AI vraagstukken. Plan een introductiegesprek in wanneer jouw organisatie ondersteuning en/of inspiraratie kan gebruiken.